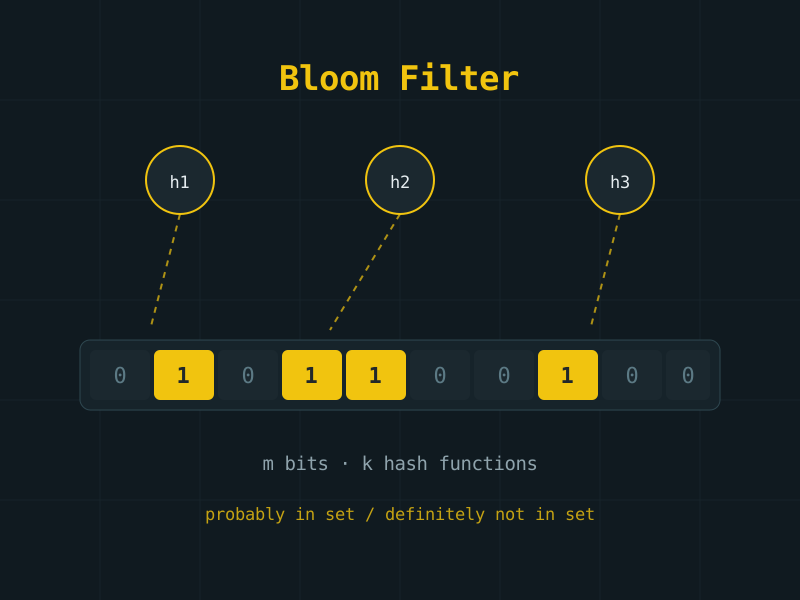
فرض کنید در حال ساخت حساب کاربری در Gmail هستید و میخواهید یک نام کاربری خاص انتخاب کنید؛ پیامی میبینید با این مضمون که «این نام کاربری قبلاً گرفته شده است». تاریخ تولدتان را هم به انتهای نام اضافه میکنید و باز هم شانسی برای گرفتن نام موردعلاقهتان ندارید. واقعاً ناامیدکننده است، نه؟
اما تا به حال فکر کردهاید که سرویس چطور در میان میلیونها نام کاربری ثبتشده، اینقدر سریع بررسی میکند که نام موردنظر آزاد است یا نه؟ راههای زیادی برای این کار وجود دارد؛ مثلاً جستوجوی خطی یا دودویی. اما هیچکدام روش خوبی نیستند، چون روی حجم زیاد داده زمان اجرای بالایی دارند. اینجاست که باید سراغ یک روش بهینه برویم.
Bloom Filter ساختار دادهای است که دقیقاً همین کار را بهصورت بهینه انجام میدهد.
برای درک Bloom Filter باید بدانید Hash چیست. تابع درهمساز (hash function) یک ورودی میگیرد و خروجی آن یک شناسه منحصربهفرد با طول ثابت است که برای شناسایی همان ورودی استفاده میشود.
تعریف Bloom Filter
Bloom Filter یک ساختار داده احتمالاتی و بسیار کممصرف از نظر فضاست که برای تست عضویت یک عنصر (مثلاً یک نام کاربری) در یک مجموعه (لیست نامهای کاربری) استفاده میشود. هزینهای که برای این کارایی میپردازیم ذات احتمالاتی آن است؛ یعنی ممکن است نتایج مثبت کاذب داشته باشیم. مثبت کاذب یعنی فیلتر بگوید نام کاربری موردنظر قبلاً استفاده شده، در حالی که واقعاً اینطور نیست.
ویژگیهای جالب Bloom Filter
- برخلاف جدول هش استاندارد، یک Bloom Filter با اندازه ثابت میتواند مجموعهای با تعداد دلخواه از عناصر را نمایش دهد.
- اضافه کردن عنصر هرگز شکست نمیخورد؛ اما نرخ مثبت کاذب با اضافه شدن عناصر پیوسته بالا میرود تا جایی که همه بیتها ۱ شوند و آنوقت همه پرسوجوها نتیجه مثبت میدهند.
- Bloom Filter هرگز منفی کاذب تولید نمیکند؛ یعنی هیچوقت نمیگوید عنصری وجود ندارد در حالی که واقعاً وجود دارد.
- حذف عنصر از فیلتر ممکن نیست. اگر بخواهیم عنصری را با صفر کردن بیتهای اندیسهای تولیدشده حذف کنیم، ممکن است چند عنصر دیگر را هم ناخواسته حذف کنیم، چون بیتها میان عناصر مشترکاند.
طبق تعریف، Bloom Filter میتواند وضعیت یک مقدار را در دو حالت گزارش کند: «احتمالاً در مجموعه هست» یا «قطعاً در مجموعه نیست». تفاوت ظریف میان احتمالاً و قطعاً نه اینجا خیلی مهم است.
فرض کنید در یک کتابخانه، اسم هر کتابی را که اضافه میکنیم در یک فهرست مینویسیم. حالا برای پیدا کردن کتاب X دیگر کل کتابخانه را نمیگردیم؛ فقط فهرست را نگاه میکنیم. اگر در فهرست بود میگوییم «احتمالاً کتاب موجود است» و اگر نبود، مطمئنیم که موجود نیست.
Bloom Filter چطور کار میکند؟
پایه کار، آرایهای از m بیت است که در ابتدا همه روی صفر تنظیم شدهاند. برای محاسبه هش هر ورودی به k تابع هش نیاز داریم. وقتی میخواهیم آیتمی را اضافه کنیم، بیتهای اندیسهای h1(x)، h2(x) تا hk(x) روی ۱ تنظیم میشوند.
مثلاً میخواهیم «geeks» را وارد فیلتر کنیم؛ از ۳ تابع هش و آرایهای با طول ۱۰ استفاده میکنیم:
h1("geeks") % 10 = 1
h2("geeks") % 10 = 4
h3("geeks") % 10 = 7
حالا «nerd» را هم اضافه میکنیم:
h1("nerd") % 10 = 3
h2("nerd") % 10 = 5
h3("nerd") % 10 = 4بیتهای اندیس ۳، ۴ و ۵ هم روی ۱ تنظیم میشوند. برای بررسی وجود «geeks» همین فرآیند را برعکس انجام میدهیم: هشها را با h1، h2 و h3 حساب میکنیم و میبینیم آیا همه این اندیسها در آرایه بیتی ۱ هستند یا نه. اگر همه ۱ بودند، «geeks» احتمالاً وجود دارد و اگر حتی یکی از آنها ۰ باشد، قطعاً وجود ندارد.
مثبت کاذب در Bloom Filter
چرا گفتیم «احتمالاً وجود دارد»؟ این عدم قطعیت از کجا میآید؟ با یک مثال روشن میشود. فرض کنید میخواهیم بررسی کنیم «cat» وجود دارد یا نه:
h1("cat") % 10 = 1
h2("cat") % 10 = 3
h3("cat") % 10 = 7
اگر آرایه بیتی را نگاه کنیم، بیتهای این اندیسها ۱ هستند؛ در حالی که «cat» هرگز به فیلتر اضافه نشده است. بیتهای ۱ و ۷ هنگام افزودن «geeks» و بیت ۳ هنگام افزودن «nerd» ست شدهاند. پس چون بیتهای اندیسهای محاسبهشده قبلاً توسط عناصر دیگری ست شدهاند، Bloom Filter بهاشتباه ادعا میکند «cat» وجود دارد و یک نتیجه مثبت کاذب میسازد.
احتمال مثبت کاذب را میتوان با کنترل اندازه فیلتر مدیریت کرد؛ فضای بیشتر یعنی مثبت کاذب کمتر. اگر بخواهیم این احتمال را کاهش دهیم باید از تعداد بیشتری تابع هش و آرایه بیتی بزرگتر استفاده کنیم، که در مقابل، تأخیر درج و بررسی عضویت را بالا میبرد.
عملیات اصلی در Bloom Filter
- درج (Insert): افزودن یک عنصر به فیلتر.
- جستوجو (Lookup): بررسی وجود یک عنصر، با احتمال مثبت کاذب.
نکته: امکان حذف یک آیتم از Bloom Filter وجود ندارد.
کجا از Bloom Filter استفاده میشود؟
- گوگل کروم: برای شناسایی URLهای مخرب
- Medium: برای پیشنهاد مقالات مرتبط
- Google و Apache: برای جستوجو و فیلتر کردن
- در شبکه، برای ارسال و دریافت بستهها
کاربردهای رایج
- جستوجو و فیلتر کردن در پایگاه داده
- آمار بازدیدکنندگان یکتای سایت
- بررسی قوی یا ضعیف بودن رمز عبور و تشخیص غلط تایپی
- استفاده در Redis
معایب Bloom Filter
- از عملیات حذف پشتیبانی نمیکند.
- نرخ مثبت کاذب را نمیتوان به صفر رساند.
- روی دیسک، بهدلیل اندیسهای تصادفی تولیدشده توسط توابع هش، به دسترسی تصادفی (random access) نیاز دارد.